Week 9. Rag & Embedding
Day3. LangChain 없이 RAG 직접 구현
이전에 “day1_문서 청킹”, “day2_벡터 임베딩 및 유사도 검색 때” 배운 내용을 종합하는 심플 프로그램을 만듭니다. 매우 간단한 SimpleVectorStore를 만들어 보며 RAG 시스템의 내부 구조의 흐름을 익히고 테스트 해보는 작업을 합니다.
실습 목표
우선 RAG의 흐름을 이해하고 ( 청크 -> 벡터 -> 검색 결과 -> 프롬프트 -> 답변 )
RAG의 핵심 3 단계를 이해합니다.
- Indexing : 문서를 청크로 나누고 벡터로 변환하여 저장
- Retrieval : 사용자 질문과 가까운 청크를 검색
- Generation : 검색된 근거를 LLM 프롬프트에 넣어서 답변 생성
미니 프로젝트 구성
우선 이번 미니 프로젝트에서 아래와 같은 구성 요소를 직접 만들어 보았습니다. (외부 패키지 설치 없이 numpy만 사용)
- 데이터 준비(
documents라는 샘플 텍스트로 진행) - 문장 단위 청킹(
sentence_chunker,make_chunks) - 간단한 TF-IDF 임베딩(
TfidfEmbedder,SimpleVectorStroe, ) - 코사인 유사도 기반 검색(
search_similar_chunks) - 검색 결과를 프롬프트에 넣어 답변 생성(
build_prompt,generate_answer)
위의 구성 요소들은 실무에서는 사실 직접 만들게 되는 경우가 많지 않다고 합니다. 실제 서비스시에는 잘 만들어진 라이브러리들이 있어서 사실 가져다가 잘 사용만 하면 되며, 미니 프로젝트의 구성 요소와 실제 서비스에서 사용할만한 라이브러리를 맵핑한 정보는 대강 아래 테이블과 같습니다.
| 미니 프로젝트 | 실제 서비스 |
|---|---|
documents 샘플 텍스트 | data/ 폴더의 PDF 문서 |
sentence_chunker, make_chunks | semantic_chunker 의미 기반 청킹 |
TfidfEmbedder | SentenceTransformer('snumin44/simcse-ko-roberta-unsupervised') |
SimpleVectorStore | FAISS 인덱스 |
search_similar_chunks | FAISS 검색 결과를 원문 청크와 연결 |
문서 준비
아래와 같이 심플하게 텍스트 형태의 데이터를 준비합니다. 각각의 데이터는 다음과 같은 key-value로 구성됩니다.
source: 정보의 근거 추적(출처) 및 중복 방지를 위해서 사용됩니다. 일종의 정보의 식별자입니다.title: 추가적인 문맥 제공하고 가독성을 높여 글 자체가 어떤 내용인지 바로 알 수 있도록 합니다.text: 실제 검색의 대상이자 LLM이 답변의 근거로 사용할 정보입니다. 이 텍스트를 chunk 단위로 나누고 벡터로 변환해서 유사한 내용을 찾습니다.
documents = [
    {
        "source": "rag_overview",
        "title": "RAG 개요",
        "text": '''
            RAG는 Retrieval-Augmented Generation의 약자로 검색 증강 생성을 의미한다.
            LLM이 모든 지식을 내부 파라미터에만 의존하지 않고, 외부 문서에서 관련 정보를 검색한 뒤 답변을 생성하는 방식이다.
            RAG는 최신 정보 반영, 출처 제공, 도메인 지식 활용, hallucination 완화에 도움이 된다.
            일반적인 RAG 파이프라인은 문서 수집, 청킹, 임베딩, 벡터 저장, 검색, 답변 생성 단계로 구성된다.
        '''
    },

    {
        "source": "chunking_notes",
        "title": "문서 청킹",
        "text": '''
            청킹은 긴 문서를 검색 가능한 작은 단위로 나누는 과정이다.
            청크가 너무 크면 검색 결과에 불필요한 정보가 많이 섞이고, 청크가 너무 작으면 문맥이 끊어진다.
            문장 단위 청킹은 구현이 단순하고 의미 단위를 보존하기 쉽다.
            오버랩을 사용하면 청크 경계에서 중요한 문맥이 사라지는 문제를 줄일 수 있다.
        '''

    },
    {
        "source": "embedding_vector",
        "title": "임베딩과 벡터 검색",
        "text": '''
            임베딩은 텍스트를 숫자 벡터로 변환하는 방법이다.
            벡터 검색은 질문 벡터와 문서 청크 벡터 사이의 유사도를 계산하여 관련 문서를 찾는다.
            코사인 유사도는 두 벡터의 방향이 얼마나 비슷한지 측정하는 대표적인 방법이다.
            실무에서는 Sentence-BERT 같은 임베딩 모델과 FAISS 같은 벡터 검색 라이브러리를 자주 사용한다.
        '''
    },
    {
        "source": "no_langchain",
        "title": "LangChain 없이 구현하기",
        "text": '''
            LangChain은 RAG 구현을 편하게 해주는 프레임워크지만, 내부 원리를 이해하려면 직접 구현해보는 것이 좋다.
            프레임워크 없이 구현할 때는 문서 로더, 청커, 임베더, 벡터 저장소, 검색기, 프롬프트 생성기를 직접 연결해야 한다.
            직접 구현하면 각 단계에서 어떤 데이터가 들어오고 나가는지 확인하기 쉽다.
            또한 검색 품질이 낮을 때 청크 크기, 유사도 기준, top_k 값 등을 조정하며 원인을 분석할 수 있다.
        '''
    },
    {
        "source": "generation_notes",
        "title": "근거 기반 답변 생성",
        "text": '''
            RAG의 답변 생성 단계에서는 검색된 문서를 그대로 LLM에게 전달하지 않고 질문과 함께 프롬프트로 구성한다.
            프롬프트에는 검색된 근거만 사용하라는 지시와 출처를 표시하라는 지시를 넣는 것이 좋다.
            검색 결과가 부족하면 모른다고 답하도록 만드는 것도 hallucination을 줄이는 데 중요하다.
        '''
    },
]
전처리 및 문장 기반 청킹
문서를 문장 단위로 나누고 여러 문장을 하나의 청크로 묶습니다. overlap을 통해서 이전 청크의 마지막 문장도 다음 청크에 포함되도록 하여 문맥이 유지되도록 합니다.
import math
import os
import re
from collections import Counter
import numpy as np
간단하게 함수 하나씩 가볍게 살펴보고 가겠습니다.
테스트로
documents의 첫 번째 요소인RAG 개요문서의text부분을 간단하게 넣어서 하나씩 돌려가며 흐름을 짚어보고자 합니다.
normalize_text함수는 공백을 하나로 합쳐서 검색 및 출력에서 가져다가 쓰기 좋은 문자열로 변경하는 함수입니다.
def normalize_text(text: str) -> str:
    """여러 공백을 하나로 합쳐 검색과 출력에 쓰기 좋은 문자열로 변환합니다."""
    return re.sub(r"\s+", " ", text).strip()

// 테스트 구문
test_text = normalize_text(documents[0].get("text"))
print(test_text)
결과를 보면 띄어쓰기로 구분된 문자열을 받을 수 있습니다.
'RAG는 Retrieval-Augmented Generation의 약자로 검색 증강 생성을 의미한다. LLM이 모든 지식을 내부 파라미터에만 의존하지 않고,...split_sentences함수는 전체 텍스트를 문장 단위로 변환하기 위해서 일반적으로 문장의 끝을 나타내는 특수 문자들 단위로 나누는 함수입니다.
p.s 요즘은 regex 문법 같은 것도 직접 구현할 필요 없이 AI를 통해서 빠르게 구현이 되니까 좋은 것 같습니다.
def split_sentences(text: str) -> list[str]:
    """마침표, 물음표, 느낌표를 기준으로 간단히 문장을 분리합니다."""
    text = normalize_text(text)
    if not text:
        return []

    sentences = re.split(r"(?<=[.!?])\s+", text)
    return [sentence.strip() for sentence in sentences if sentence.strip()]

// 테스트 구문
test_text_list = split_sentences(nom_text)
print(test_text_list)
아래와 같이 특수문자 .?!로 구분된 문장들이 담긴 리스트를 반환합니다.
['RAG는 Retrieval-Augmented Generation의 약자로 검색 증강 생성을 의미한다.',
'LLM이 모든 지식을 내부 파라미터에만 의존하지 않고, 외부 문서에서 관련 정보를 검색한 뒤 답변을 생성하는 방식이다.',
'RAG는 최신 정보 반영, 출처 제공, 도메인 지식 활용, hallucination 완화에 도움이 된다.',
'일반적인 RAG 파이프라인은 문서 수집, 청킹, 임베딩, 벡터 저장, 검색, 답변 생성 단계로 구성된다.']sentence_chunker함수는 입력 텍스트를 문장 단위로 쪼갠 후 청크로 나눠 담습니다.
여기서 overlap으로 겹칠 범위를 설정(step을 sentences_per_chunk에서 overlap만큼 후퇴 시켜 겹치도록 만듦)하고 sentences_per_chunk로 하나의 청크를 몇 문장으로 할지 정합니다.
p.s overlap을 하도록 하면 문장의 맥락을 잃지 않도록 할 수 있습니다.
def sentence_chunker(text: str, sentences_per_chunk: int = 2, overlap: int = 1) -> list[str]:
    """문장 여러 개를 하나의 청크로 묶습니다."""
    if sentences_per_chunk <= 0:
        raise ValueError("sentences_per_chunk는 1 이상이어야 합니다.")
    if overlap < 0:
        raise ValueError("overlap은 0 이상이어야 합니다.")
    if overlap >= sentences_per_chunk:
        raise ValueError("overlap은 sentences_per_chunk보다 작아야 합니다.")

    sentences = split_sentences(text)
    step = sentences_per_chunk - overlap
    chunks = []

    for start in range(0, len(sentences), step):
        chunk_sentences = sentences[start:start + sentences_per_chunk]
        if chunk_sentences:
            chunks.append(" ".join(chunk_sentences))
        if start + sentences_per_chunk >= len(sentences):
            break

    return chunks

// 테스트 구문
print(sentence_chunker(documents[0]["text"]))
default 값으로 2문장씩 chunking 하는데 overlap을 1개를 줘서 chunk당 2문장 그리고 1문장씩 겹치게 됩니다.
['RAG는 Retrieval-Augmented Generation의 약자로 검색 증강 생성을 의미한다. LLM이 모든 지식을 내부 파라미터에만 의존하지 않고, 외부 문서에서 관련 정보를 검색한 뒤 답변을 생성하는 방식이다.',
'LLM이 모든 지식을 내부 파라미터에만 의존하지 않고, 외부 문서에서 관련 정보를 검색한 뒤 답변을 생성하는 방식이다. RAG는 최신 정보 반영, 출처 제공, 도메인 지식 활용, hallucination 완화에 도움이 된다.',
'RAG는 최신 정보 반영, 출처 제공, 도메인 지식 활용, hallucination 완화에 도움이 된다. 일반적인 RAG 파이프라인은 문서 수집, 청킹, 임베딩, 벡터 저장, 검색, 답변 생성 단계로 구성된다.']make_chunks는 사실상 사용자 입장에서 접하는 잘 추상화된 함수로, 문서, 청크 사이즈, overlap 사이즈 이렇게 3개를 지정해서 청킹을 해서 리스트 형태로 반환하는 함수입니다.
def make_chunks(
    docs: list[dict],
    sentences_per_chunk: int = 2,
    overlap: int = 1,
) -> list[dict]:
    """문서 목록을 메타데이터가 포함된 청크 목록으로 변환합니다."""
    chunks = []
    for doc in docs:
        for chunk_index, chunk_text in enumerate(
            sentence_chunker(doc["text"], sentences_per_chunk, overlap),
            start=1,
        ):
            chunks.append(
                {
                    "chunk_id": f"{doc['source']}#{chunk_index}",
                    "source": doc["source"],
                    "title": doc["title"],
                    "chunk_index": chunk_index,
                    "text": chunk_text,
                }
            )
    return chunks


chunks = make_chunks(documents, sentences_per_chunk=2, overlap=1)
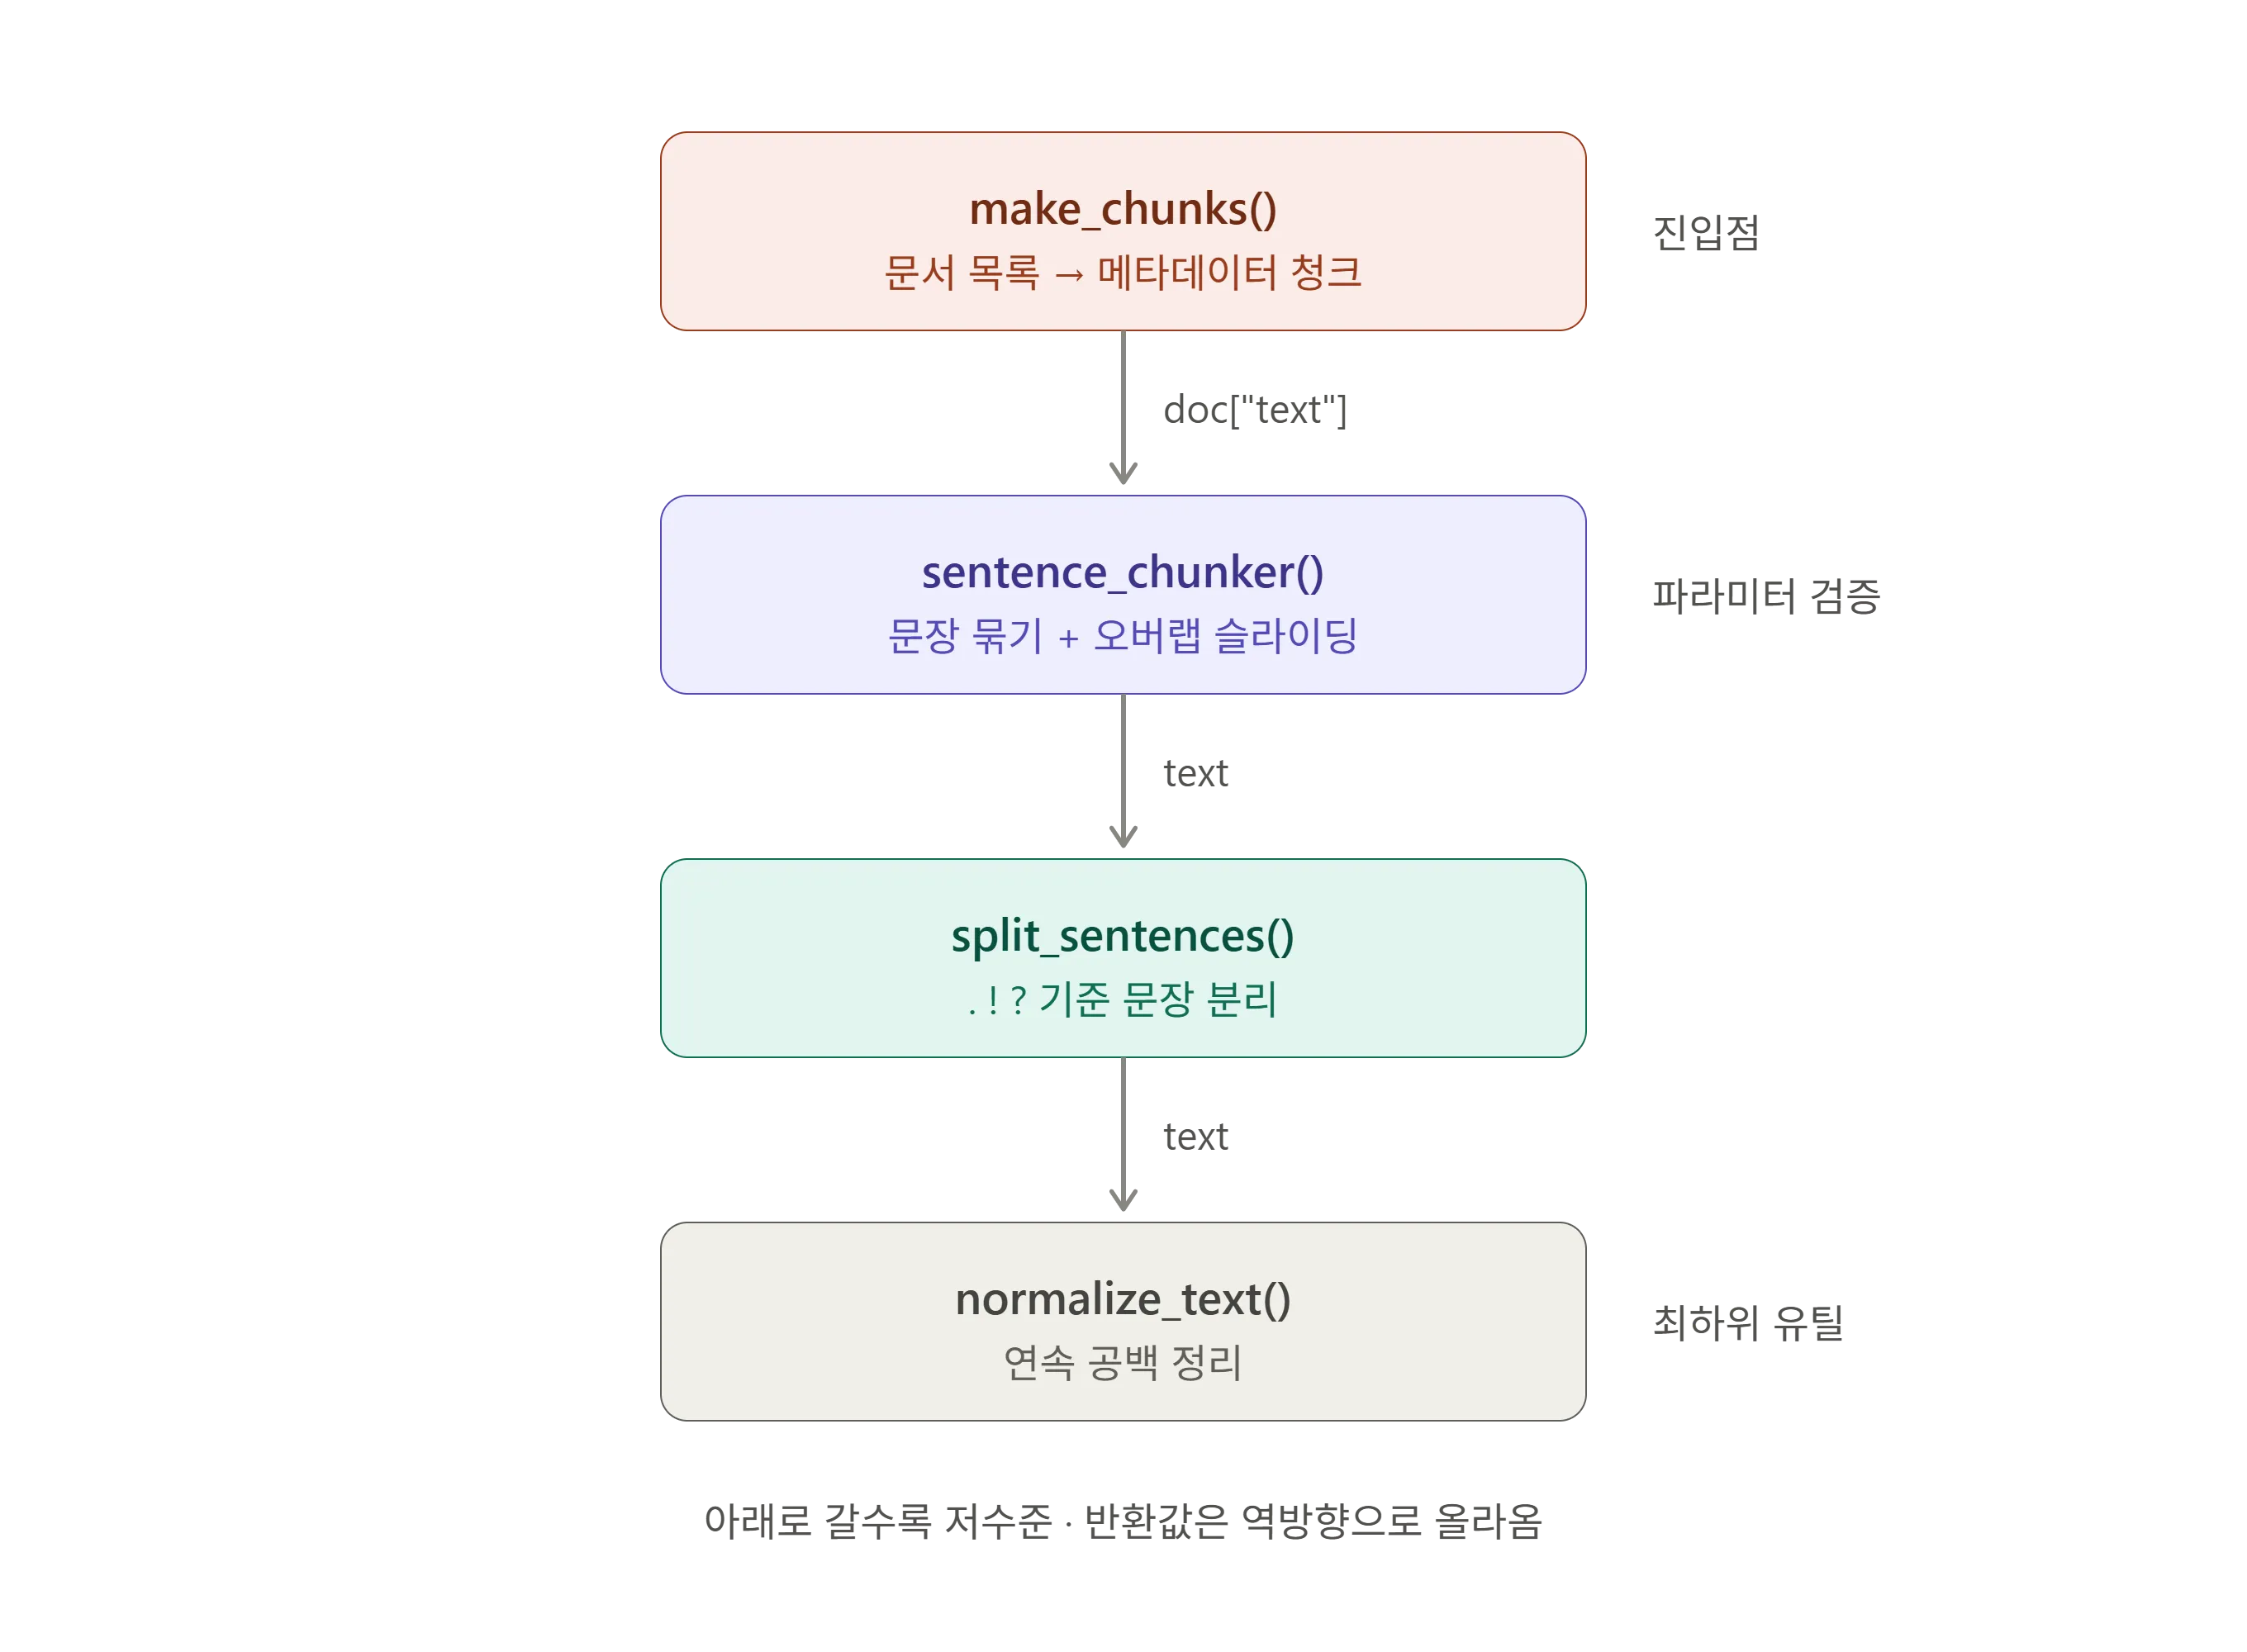
최종 결과물의 함수 흐름을 보면 아래와 같습니다. 그렇게 복잡한 부분은 없습니다 ― chunking에서 복잡한 기술을 사용하지 않았기 때문에 비교적 간단하게 구현되었습니다. 나중에 chunking 기술들도 공부해서 글을 적어보겠습니다.
Simple TF-IDF 임베딩 구현
미니 프로젝트에서는 일반적으로 사용하는 임베딩 모델(SentenceTransformer) 대신해 직접 간단하게 TF-IDF 임베딩을 구현합니다.
TF-IDF란?
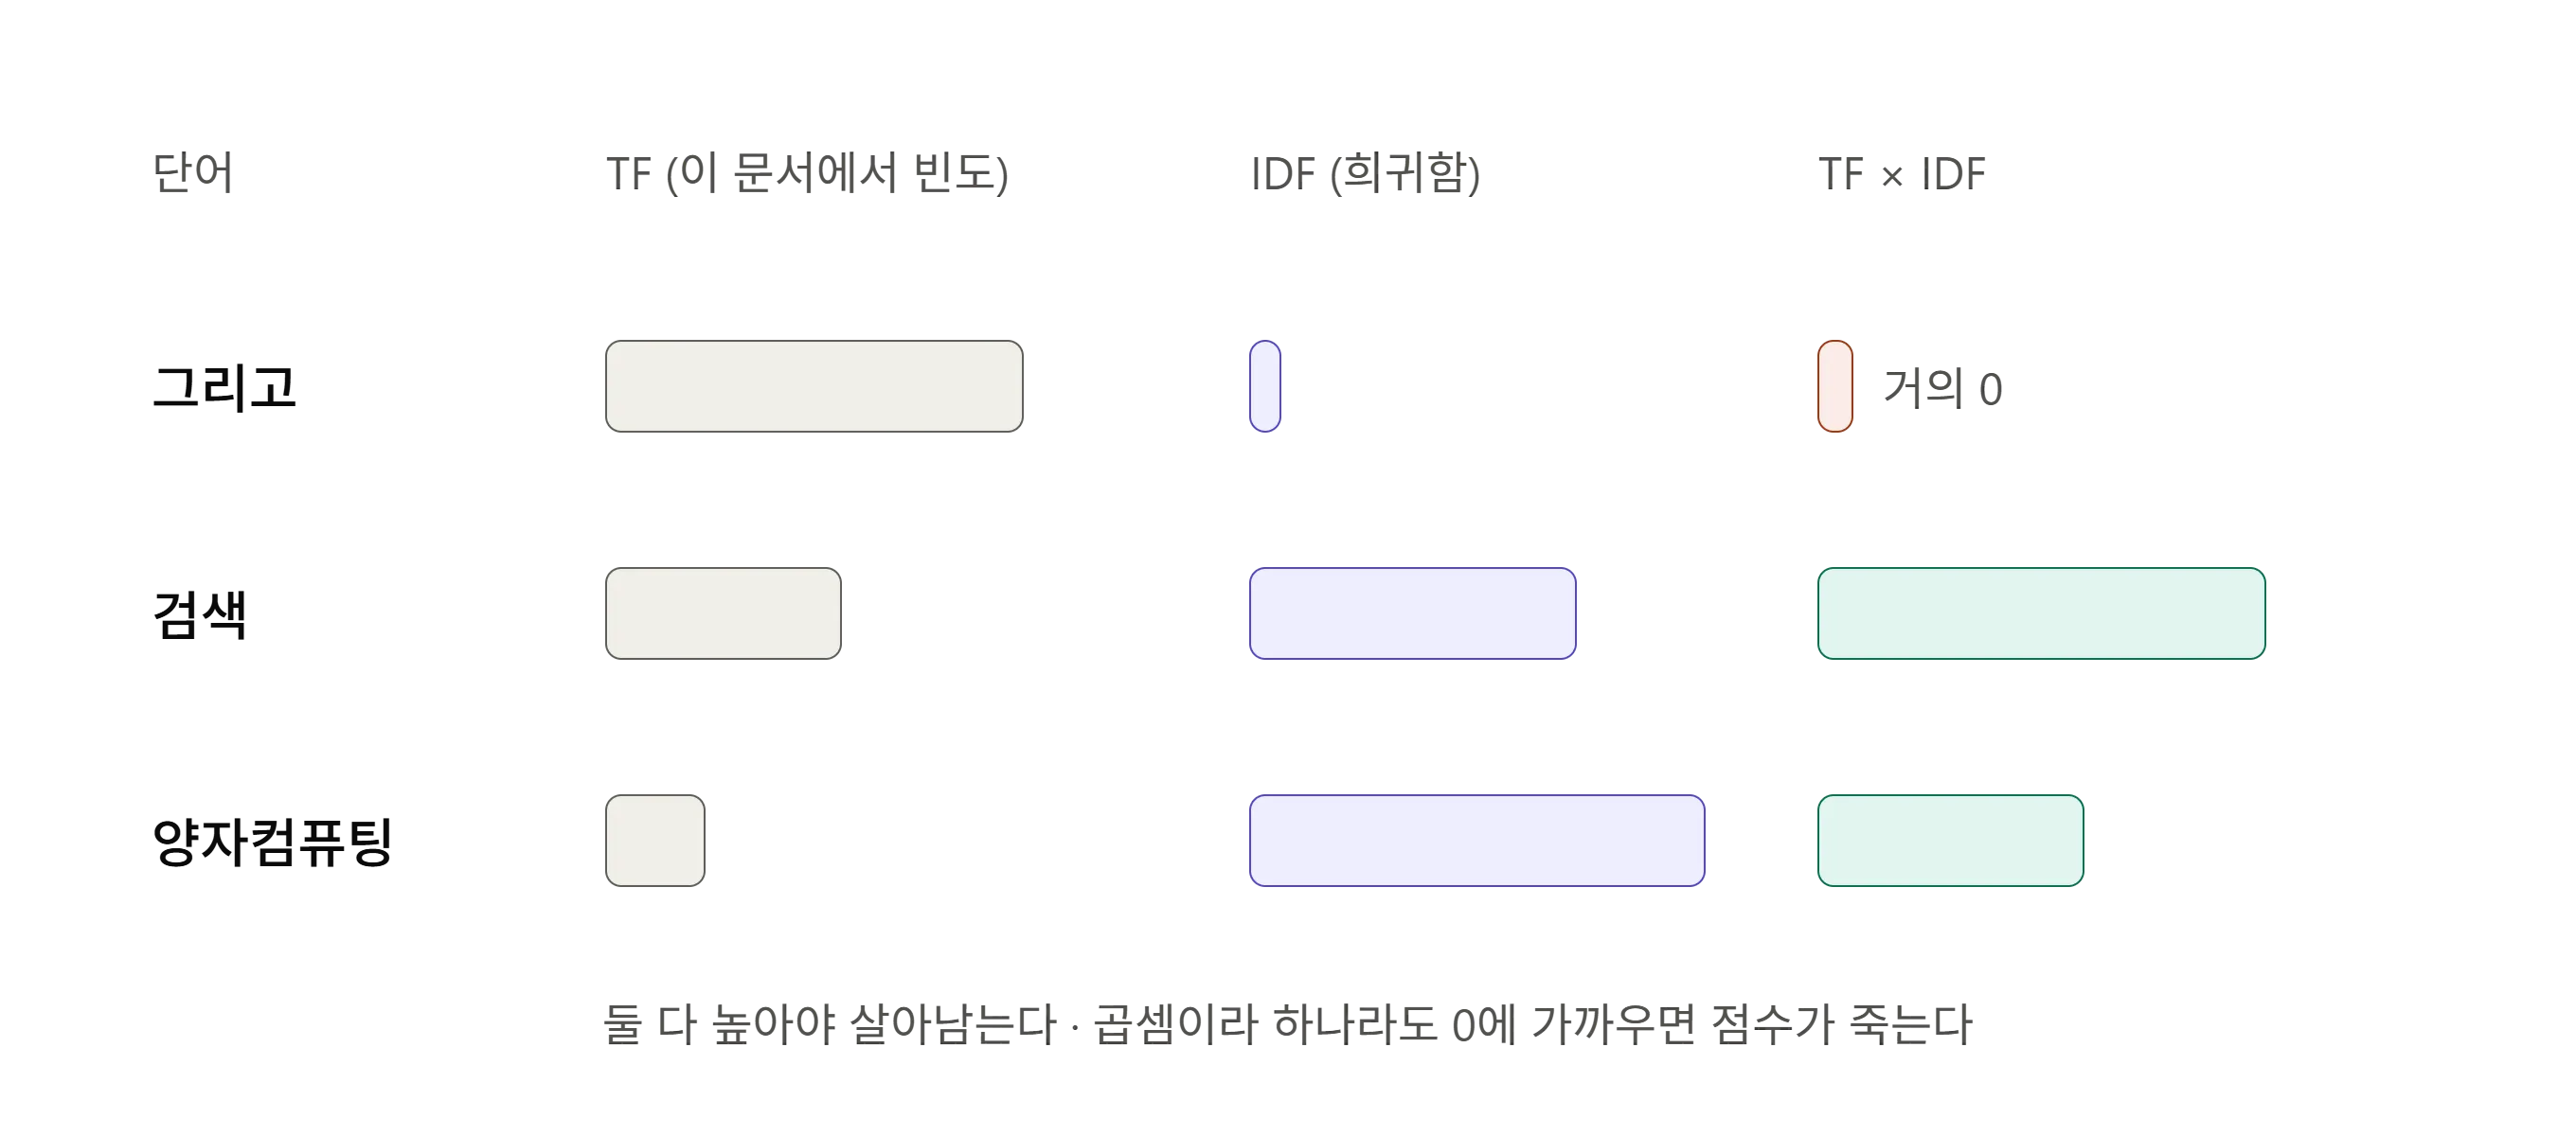
우선 구현하기 전에 TF-IDF가 뭔지 간단하게 조사해서 공부하고 진행하겠습니다. TF-IDF의 핵심은 “이 문서를 대표하는 단어는 뭔가?” 에 답하기 위한 두 가지 상식을 곱한 것입니다.
각각의 TF, IDF가 뜻하는 바는 아래와 같습니다.
- *TF(Term Frequency) : 이 문서에서 자주 나오면 중요하다.
- “검색”이 10번 나온 문서는 1번 나온 문서보다 검색에 대한 문서일 가능성이 높죠.
- *IDF(Inverse Document Frequency) : 모든 문서에 나오는 단어는 쓸모없다.
- “그리고”, “합니다”는 어느 문서에나 자주 나옵니다. TF만 보면 이런 단어가 1등 차지하게 됩니다. 그래서 “전체 문서 중 몇 개에 등장하는가(DF)“의 역수를 곱해서 흔한 단어의 가중치를 깎아내립니다.
핵심은 TF와 IDF를 곱한다는 데 있습니다. 둘 중 하나라도 0에 가까우면 점수가 죽습니다. 즉 생존한 단어는 “이 문서에는 자주 나오는데, 다른 문서에는 잘 안 나오는” 단어 뿐이며, 그게 바로 이 문서를 다른 문서와 구별해주는 단어입니다.
 하지만 이렇게 값만 곱하고 끝난다면 가중치의 차이가 너무 커지기에 log를 씌워 그 값의 차이를 줄이게 됩니다.
전 통계학이나 수학을 전공하지는 않았기에 여기서 한 가지 의문이 들었었는데요 “왜 하필이면 로그를 씌운걸까?”라는 의문이 들었고 그 이유를 찾아보기로 했습니다.
TF x IDF 에 Log를 씌우는 이유
하지만 한계점이 명확합니다. 단어의 빈도 통계에 의존한 임베딩 모델로 단어의 동의어 구분, 문맥 이해 같은게 불가하여 semantic 검색이나 문장/문서 임베딩 보다는 키워드 추출, 문서 유사도의 간단한 근사치 비교 같은 곳에 쓰입니다.
사실 실무에서는 직접 임베딩 구현까지 하게 될 일이 많지 않을 거라 ― 잘 만들어진걸 가져다 사용하니… ― 코드보다는 큰 흐름을 이해하는게 중요하다고 생각이 드네요 ― 어차피 필요하면 그때 가서 또 찾아봐야 합니다.
흐름은 아래와 같습니다.
- 텍스트가 토큰으로 나뉜다.
- 토큰이 숫자 벡터로 바뀐다.
- 벡터는 코사인 유사도 검색에 사용된다.
다음으로 Simple TF-IDF 임베딩 구현 부분입니다.
우선 토큰화를 진행할 문자열 셋의 패턴과 접미사의 패턴을 아래와 같이 정의했습니다.
긴 접미사 -> 짧은 접미사 순서로 정렬되도록 했는데요, 간혹 아래와 같은 문제가 발생해 이를 방지하기 위함입니다.
예시 : “인공지능이라는” → “라는” 먼저 매칭 → “인공지능이” ← 어간에 ‘이’가 남음
TOKEN_PATTERN = re.compile(r"[가-힣A-Za-z0-9_]+")
KOREAN_SUFFIXES = tuple(sorted((
    "입니다", "인가요", "가요", "나요", "에서", "으로", "에게", "한테",
    "라는", "이라는", "라고", "처럼", "보다", "부터", "까지",
    "은", "는", "이", "가", "을", "를", "와", "과", "도", "만", "의", "에", "로", "요",
), key=len, reverse=True))tokenize함수는 입력한 문자열에서 어근만을 떼어내어 토큰으로 바꿔 리스트에 저장하고 그 리스트를 반환합니다.
여기서 확인하고 넘어갈 점은 떼어내고 남는 어근을 최소 2글자 이상 남긴다는 점입니다.
어근을 최소 2글자 이상 남기는 이유
어근이 최소 2글자 이상이 보장된다는 부분은
len(token) > len(suffix) + 1 이 부분에서 확인이 가능한데요.
조금 식을 바꿔보면
len(token) - len(suffix) >= 2 이렇게 되는데
보시는 것 처럼 “문자열에서 접미사를 뗀 글자가 2글자 이상이다.” 라는 것을 좀 더 직관적으로 확인이 가능하죠.
이게 형태소 사전을 사용하지 않고 있기 때문에 오분할(false splitting)을 막기 위한 일종의 안전장치인데요 ― 한국어에서는 2음절 명사가 조사와 같은 글자로 끝나는 경우가 굉장히 많기 때문입니다.
예를 들어서 사과 라는 단어가 있다고 치면 과도 사실 접미사중 하나가 있지만 사과는 그냥 명사 사과잖아요? 저런식의 단어가 꽤~~~ 많아서 저런 오분할을 막기 위함입니다.
def tokenize(text: str) -> list[str]:
    """한글, 영문, 숫자 토큰을 추출하고 자주 쓰는 한국어 조사를 가볍게 정리합니다."""
    tokens = []

    for token in TOKEN_PATTERN.findall(text.lower()):
        tokens.append(token)

        for suffix in KOREAN_SUFFIXES:
            if token.endswith(suffix) and len(token) > len(suffix) + 1:
                tokens.append(token[:-len(suffix)])
                break

    return tokens
다른 외부 라이브러리를 사용하지 않는 TF-IDF 임베더 부분입니다. 세세한 부분들 보다는 핵심 아이디어만 얻어가면 될 것 같습니다.(직접 구현할 일이 있을까 해서..)
핵심 아이디어 “모든 문서에 다 나오는 흔한 단어는 별로 중요하지 않고, 특정 문서에만 자주 나오는 단어가 그 문서를 잘 설명한다.”
확인하고 넘어갈 만한 부분은 math.log((1 + n_docs) / (1 + df)) + 1 이 부분인것 같습니다.
실질적인 단어 별 가중치를 구하는 공식인데, scikit-learn라이브러리에 있는 smooth_idf=True와 같은 방식으로 smoothing을 하여 기존 IDF 공식에서 분자 분모에 1씩 더하는 공식을 사용합니다.
class TfidfEmbedder:
    """외부 라이브러리 없이 동작하는 작은 TF-IDF 임베더입니다."""

    def __init__(self):
        self.vocabulary_: dict[str, int] = {}
        self.idf_: np.ndarray | None = None
	# texts는 문서 리스트
    def fit(self, texts: list[str]):
        tokenized_docs = [tokenize(text) for text in texts]
        document_frequency = Counter()

        for tokens in tokenized_docs:
		    # 전체 문서에서 몇개의 문서에 등장했는지 확인(set을 사용한 이유)
			# 중복 제거 후 Counter 객체로 할당
            document_frequency.update(set(tokens))

        # Dictionary Comprehension으로 단어 사전 만들기
        self.vocabulary_ = {
            token: index
            for index, token in enumerate(sorted(document_frequency.keys()))
        }

        # 전체 문서 수
        n_docs = len(texts)
        # IDF 배열을 준비
        self.idf_ = np.zeros(len(self.vocabulary_), dtype=np.float32)


        for token, index in self.vocabulary_.items():
            df = document_frequency[token]
            # 중요한 부분은 아래 공식으로 단어의 문서에서의 희귀도(IDF)를 구할 수 있다는 것
            # 이게 TF-IDF에서 단어별 가중치? 라고 하네요. 이정도만 체크하고 넘어갑니다.
            self.idf_[index] = math.log((1 + n_docs) / (1 + df)) + 1

        return self
transform 메서드는 fit을 통해서 만든 vocabulary_(단어 사전)과 idf_(단어 별 가중치)를 가지고 실제 문장을 벡터화 해서 반환하는 메서드입니다.
    def transform(self, texts: list[str]) -> np.ndarray:
        if self.idf_ is None:
            raise ValueError("fit을 먼저 호출해야 합니다.")

        matrix = np.zeros((len(texts), len(self.vocabulary_)), dtype=np.float32)

        for row, text in enumerate(texts):
	        # fit에서와 달리 문서 내에서 토큰이 몇번 등장했는지 셈
            counts = Counter(tokenize(text))
            # 전체 단어 개수 후에 divide by zero를 피하기 위해 최소값 1
            total = sum(counts.values()) or 1


            for token, count in counts.items():
                column = self.vocabulary_.get(token)
                if column is not None:
                    tf = count / total
                    # ex. 1번째 문서에 "RAG" 라는 단어의 임베딩한 벡터값을 저장.
                    matrix[row, column] = tf * self.idf_[column]

        # 문서별 유클리드 거리를 구합니다.(벡터의 크기)
        norms = np.linalg.norm(matrix, axis=1, keepdims=True)

        # 벡터값을 벡터의 크기로 나눠서 벡터 방향만 남긴다.
        return matrix / np.maximum(norms, 1e-12)
    def fit_transform(self, texts: list[str]) -> np.ndarray:
        self.fit(texts)
        return self.transform(texts)
RAG System을 구축 단계 정리하기
RAG에는 학습이 없다.
- Data, 자료, 정보 등을 준비한다.
- crawling, scraping, mining
- PDF, 이미지, 영상, 자연어
- 전처리 (preprocessing)
- 불순 데이터, 내가 원하지 않는 데이터등을 거르기 위함
- 내가 원하는 형태로 가공하기 위해
- 인위적인 가공은 지양(ETL에서 Transform은 안하는게 좋음) -> similarity 따지기, 가공하면 데이터들이 비슷해 지는 경향이 있음
- Extract, Parsing
- Chunking
- 단어 기준
- 문장 기준
- 문맥 기준
- 의미 기준
- 요즘 LLM은 Context window가 늘어서 문맥, 의미 기반 청킹이 가능해짐
- 임베딩(변환)
- 컴퓨터가 알아들을 수 있게 하기 위해서
- Vector화(Vectorization)로 -1 ~ 1 사이의 값으로 치환
- 임베딩된 벡터 데이터의 차원은 tokenizer의 dimension을 따라간다.
- 단어들을 규격(vocabulary)에 맞춰서 토큰화(Tokenization)
- 시제를 나눔.(ex. )
- 벡터화를 진행이유? : 내가 검색한 값과 유사한 값을 검색하기 위해서
- VectorDB 구축
- Vector에 키 밸류를 기준으로 인덱싱 매핑
- 들어온 질문을 토대로 vectorDB에서 유사한 값 찾기
- cosine similarity, 유클리디안, 맨헤튼 distance 기준으로 유사한 값 찾음
- 유사한 값끼리는 동일한 클러스터에 존재.(비슷한 방향과 거리, 코사인 유사도가 1에 가까워짐)
- 반대의 뜻을 가진 값끼리는 서로 반대 방향에 존재(반대)
- 0에 가까울 수록 관련이 없다.
- $(AB)/(|A||B|)$
- 유사한 값을 찾아올 때에 기본적으로 전체를 다 찾는데.
- 계산 효율성을 위해서 vector partitioning
- voronoi cells(개념적 범위, 물리적으로 파티션을 나누는건 아님, 매번 기준을 뭘로 잡냐에 따라서 달라짐)로 나눈다.
VectorDB가 그렇게 좋으면 RDB도 그냥 다 대체하면 되는거 아니야? 놉… VectorDB가 사이즈가 너무 커지면 검색의 효율이 떨어지기도 하고 정형 데이터에서는 RDB로 철저하게 관리하는게 더 정확한 정보를 조회 가능.